
AI Coding的Token到底花在哪里
最近在使用 Codex、Claude Code、Kimi Code 这些工具时,我一直有一个疑问:
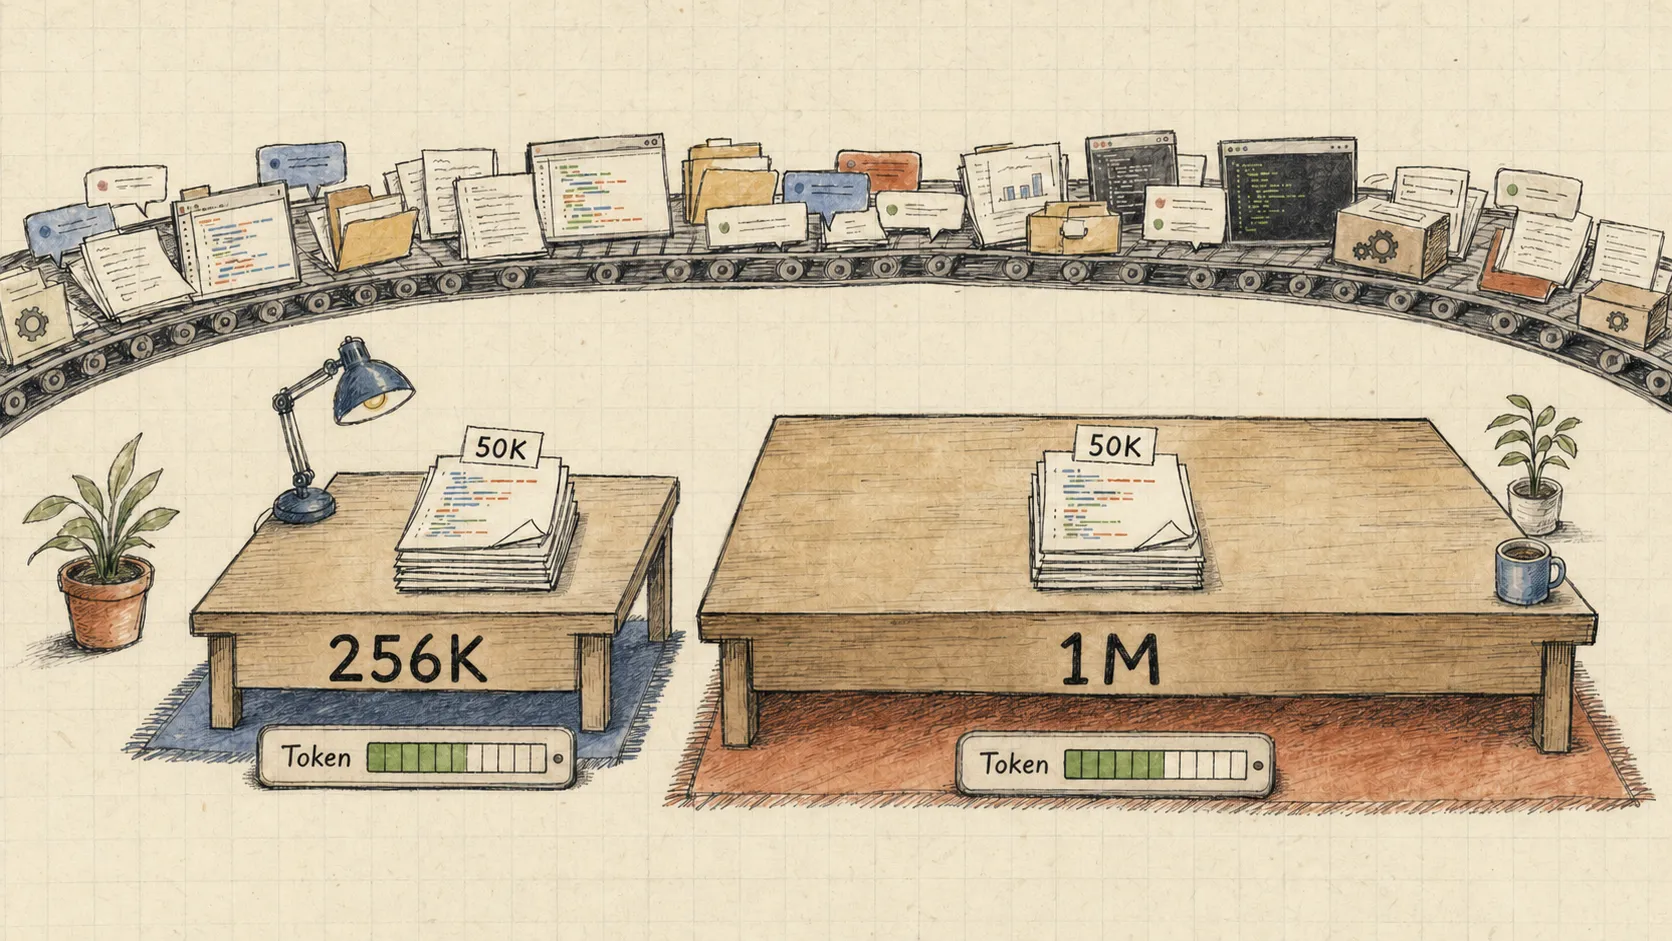
如果一个模型支持 1M 上下文,但是我实际只用了 50K Token,它会不会比 256K 上下文的模型更贵?
一开始我下意识觉得,上下文窗口越大,消耗应该越高。后来仔细拆了一下才发现,这里混淆了三个东西:
- 最大上下文容量
- 当前请求的实际上下文长度
- 多轮任务累计消耗的 Token
影响成本的是每次请求到底带了多少内容,以及这些内容被重复带了多少次,模型标注的最大上下文窗口倒没什么关系。
上下文窗口不是实际消耗
上下文窗口可以理解成 AI 的工作台。
256K 和 1M 的区别,只是工作台最多能摆多少材料。1M 上下文并不意味着每次请求都会自动消耗 1M Token。
假设两个模型的定价、缓存策略和其他配置完全相同:
- 1M 模型实际输入 50K
- 256K 模型实际输入也是 50K
那么 Token 消耗基本相同。
上下文窗口更像油箱容量,不是汽车油耗。大油箱不会让车在同一段路上自动多耗油。
不同上下文规格的价格可能不一样,有些服务给超长上下文设置不同单价,或者输入超过某个长度后换一档计费,因此判断成本还要看具体模型的价格规则。
每次请求都带了什么
很多人对 Token 消耗的理解是:
我问一句,AI 回一句,只计算这两句话。
实际的 Agent 工具通常还会带上很多内容,比如:
- 系统提示词
- AGENTS.md、CLAUDE.md 等项目规则
- 工具定义
- 当前任务说明
- 之前的对话
- 读取过的代码和文档
- Shell 命令输出
- 测试日志
- Git diff
- 压缩后的历史摘要
用户新输入的那句话,可能只有十几个 Token,但是这次请求的完整输入已经有几十万 Token。
比如到了某一轮,我只输入了一句“继续修复”,但是当前请求可能包含:
系统与工具说明       10K
项目规则与任务说明    10K
历史对话             60K
代码和文档           50K
Shell 与测试输出      20K
本轮问题              10
这次请求的输入大约 150K。
实际工具不会原样重发所有历史,有些内容被缓存了,有些已经压缩,也有些只保存在本地、需要时才读取。但是要看的是最终送进模型的上下文,不是自己刚输入了几个字。
烧 Token 的是多轮累计
长对话最容易忽略的,是历史上下文会在后面的每次请求里重复出现。
假设一个任务开始时有 20K 基础上下文,之后每轮新增 10K 内容:
第 1 轮:20K
第 2 轮:30K
第 3 轮:40K
第 4 轮:50K
第 5 轮:60K
第五轮的上下文只有 60K,但是前五轮累计输入已经是:
20K + 30K + 40K + 50K + 60K = 200K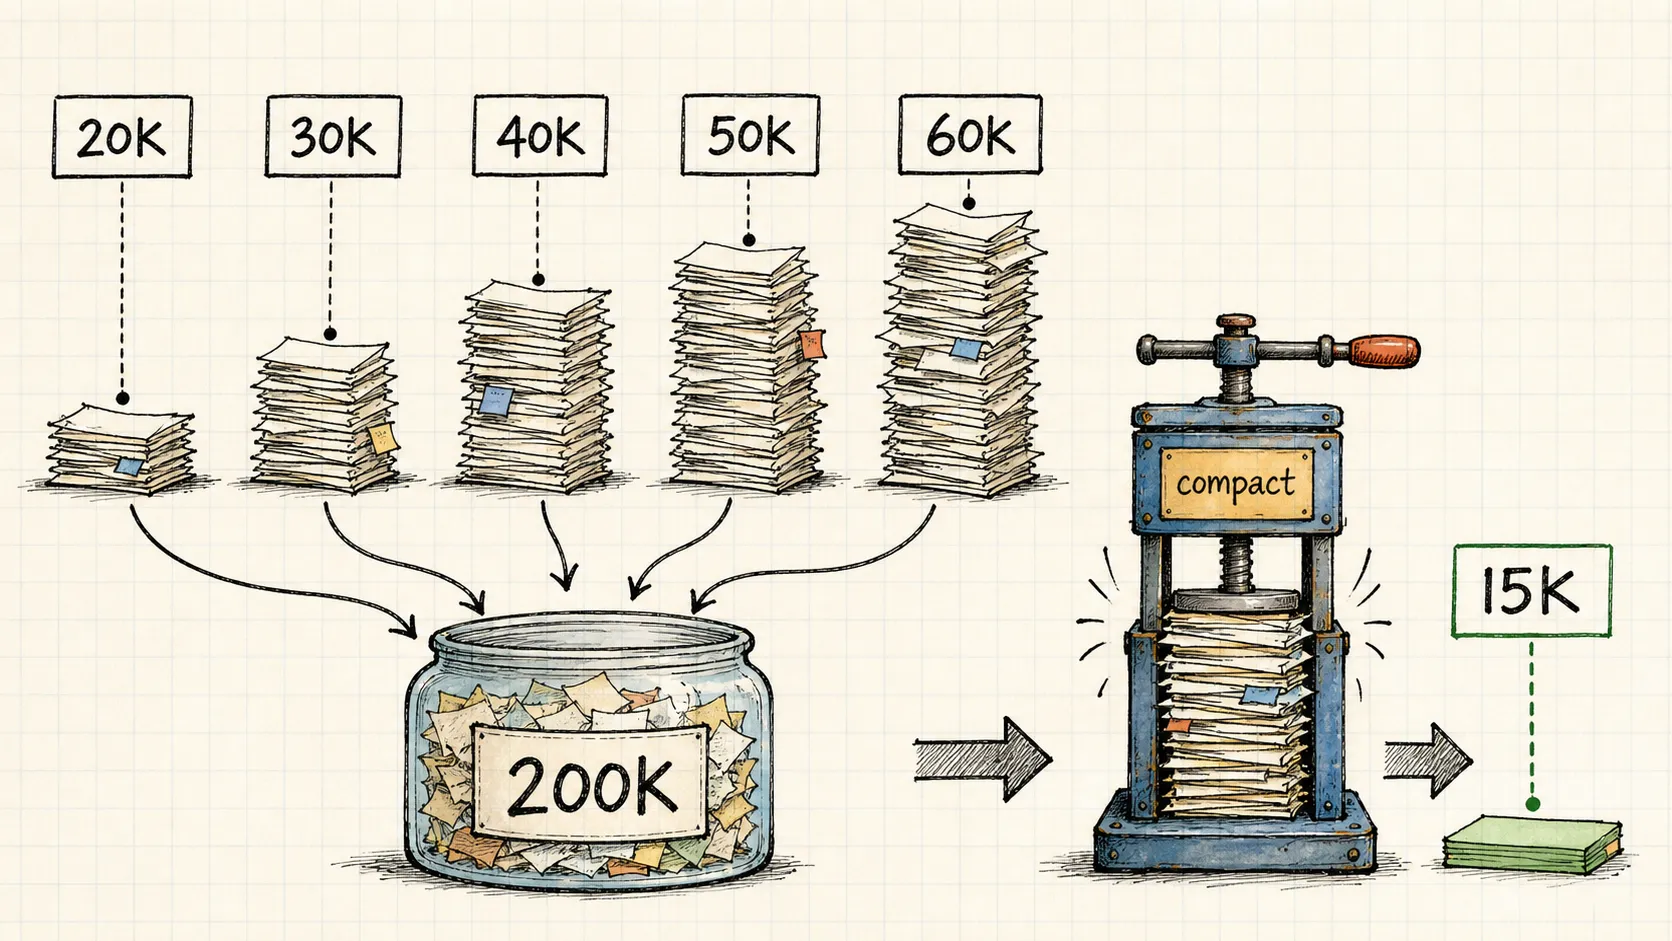
这也是为什么一个会话用得越久,Token 消耗可能越来越快。
如果每轮都增加差不多数量的历史,又没有缓存、压缩或清理,累计输入会接近二次增长,任务轮数翻倍,总消耗不止翻倍。
之前我比较关注“这次任务占用了多少上下文”,后来发现更该看的是:
这段上下文被模型重复读取了多少轮。
缓存只降价格,大上下文还在
Prompt Cache 对稳定、重复的上下文收更低的价格。
比如系统提示词、工具定义和没有变化的项目说明,连续请求的前缀相同,就可能命中缓存。
但是缓存命中不等于免费,计费通常包括:
- 普通输入 Token
- 缓存写入 Token
- 缓存读取 Token
- 输出 Token
- 部分产品单独统计的推理 Token
缓存读取一般比普通输入便宜,也不是零成本。
高缓存命中率也可能只是说明,每次请求都带着一个非常大的固定前缀。就像一辆车的单位油耗很低,但是每天开一千公里,总油耗还是很高。
因此要同时看:
- 当前上下文长度
- 普通输入量
- 缓存读取量
- 输出量
- 整个任务累计消耗
- 任务最终完成质量
小上下文为什么经常显得更省
小上下文模型的隐藏作用,是迫使 Harness 更早处理历史。
当会话接近上下文上限时,Codex、Claude Code 之类的工具可能会进行自动压缩,把大量历史整理成一份摘要:
原始历史
├── 讨论过的方案
├── 读取过的文件
├── 多次工具调用
├── 已完成的修改
├── 测试失败记录
└── 中间推理过程

压缩后
├── 当前目标
├── 已完成内容
├── 关键决策
├── 当前代码状态
└── 下一步任务
原来 200K 的历史,可能被压缩成十几 K。之后的请求只需要携带摘要和当前工作内容,单轮输入自然会下降。
因此小上下文窗口能间接省钱,窗口本身没有更便宜,是它更早触发了上下文清理。
这有点像给程序设置内存限制。内存无限时,开发者容易把什么都留在缓存里;内存有限时,系统会更早做分页、淘汰和持久化。
自动压缩也有成本
但是小窗口不一定更省,自动压缩有两个代价。
第一个是压缩本身也要消耗 Token,模型要读取旧上下文,再生成新的摘要。后面如果还有很多轮工作,这次成本通常可以被减少的重复输入抵消。
第二个是信息损失。摘要不可能保留全部细节,一次失败的尝试、某个边界条件、测试日志中的一行错误,当时看起来不重要,后面排查问题时可能又需要。丢了这些信息,Agent 就要重新读取文件、运行命令或者重复排查,压缩太频繁,总成本反而会增加,任务质量也会受影响。
因此我的做法是,上下文里低价值的内容明显多起来的时候,做一次 checkpoint。
大上下文什么时候反而更合适
有些任务确实需要较大的工作集,比如:
- 跨多个模块的架构迁移
- 全仓库安全或质量审查
- 需要关联大量调用链的复杂 Debug
- 大量文档之间的交叉分析
- 不能随意丢失前面证据的长程任务
如果任务本身需要同时比较 500K 内容,那么强行塞进 256K 窗口,可能需要多次拆分、总结和重新读取。
这种情况下,用较大的上下文一次完成全局分析,累计成本可能反而更低,结果也更稳。
因此我现在的原则是按任务实际需要选窗口,选能舒服容纳当前任务的最小上下文,不默认最大或最小。
如何管理 AI Coding 的上下文
整理完这些,我准备这样调整自己的使用方式。
一个会话只保留一个主要目标
不要在同一个会话里先设计架构,再实现几个无关功能,接着写文档,最后又做全仓库 Review。
这些任务虽然属于同一个项目,需要的材料不同。全部堆在一个会话里,之前读取的文件和工具输出会不断污染后面的上下文。同一个项目里不同任务也要分开会话。
把长期状态写入文件
聊天记录不应该成为项目状态的唯一载体。
需要跨会话保留的内容,可以放进:
docs/architecture.md
docs/decision-log.md
task.md
progress.md
AGENTS.md
其中分别记录:
- 稳定的架构说明
- 已确认的关键决策
- 当前任务边界
- 已完成内容和下一步
- 长期工作规则
新会话只读取与当前任务有关的文件,不需要继承完整聊天历史。
控制工具输出
AI Coding 里很大一部分上下文是日志,不是代码。
比如:
- 一次输出几千行的测试
- 整个目录的递归列表
- 没有限制范围的代码搜索
- 重复读取相同文件
- 把完整构建日志留在会话里
很多时候有用的只有错误附近几十行。
因此命令要尽量限制范围,先搜索定位,再读相关片段,测试输出优先留失败摘要和关键堆栈。少读无关内容,比后面再压缩更有效。
在任务边界做 checkpoint
当一个阶段结束时,可以把当前状态整理为:
## 任务目标

## 已完成

## 修改的文件

## 关键决策

## 验证结果

## 未解决问题

## 下一步
如果后续任务和当前上下文已经明显不同,就从这份 checkpoint 开一个新会话。
这比等到窗口快满时被动压缩更可控,这时我还知道哪些信息最重要。
给上下文设置预算
可以给自己设置一个简单的 Context Budget:
- 低于 50%:正常执行
- 50%~70%:减少大范围读取,清理无关输出
- 70%~85%:生成 checkpoint,判断当前阶段能否尽快结束
- 超过 85%:优先压缩或切换会话,并为模型输出和工具结果预留空间
这个比例要根据工具的压缩方式和任务类型调整,目的是不等到上下文塞满才处理。
后面选模型
后续选择模型时,我不会只比较上下文窗口大小,会先问三个问题:
- 这个任务需要同时看到多少材料?
- 这些材料会在后续请求中重复多少轮?
- 哪些状态应该继续留在上下文,哪些应该写入文件?