
AI 提效之后,如何持续找到值得做的需求
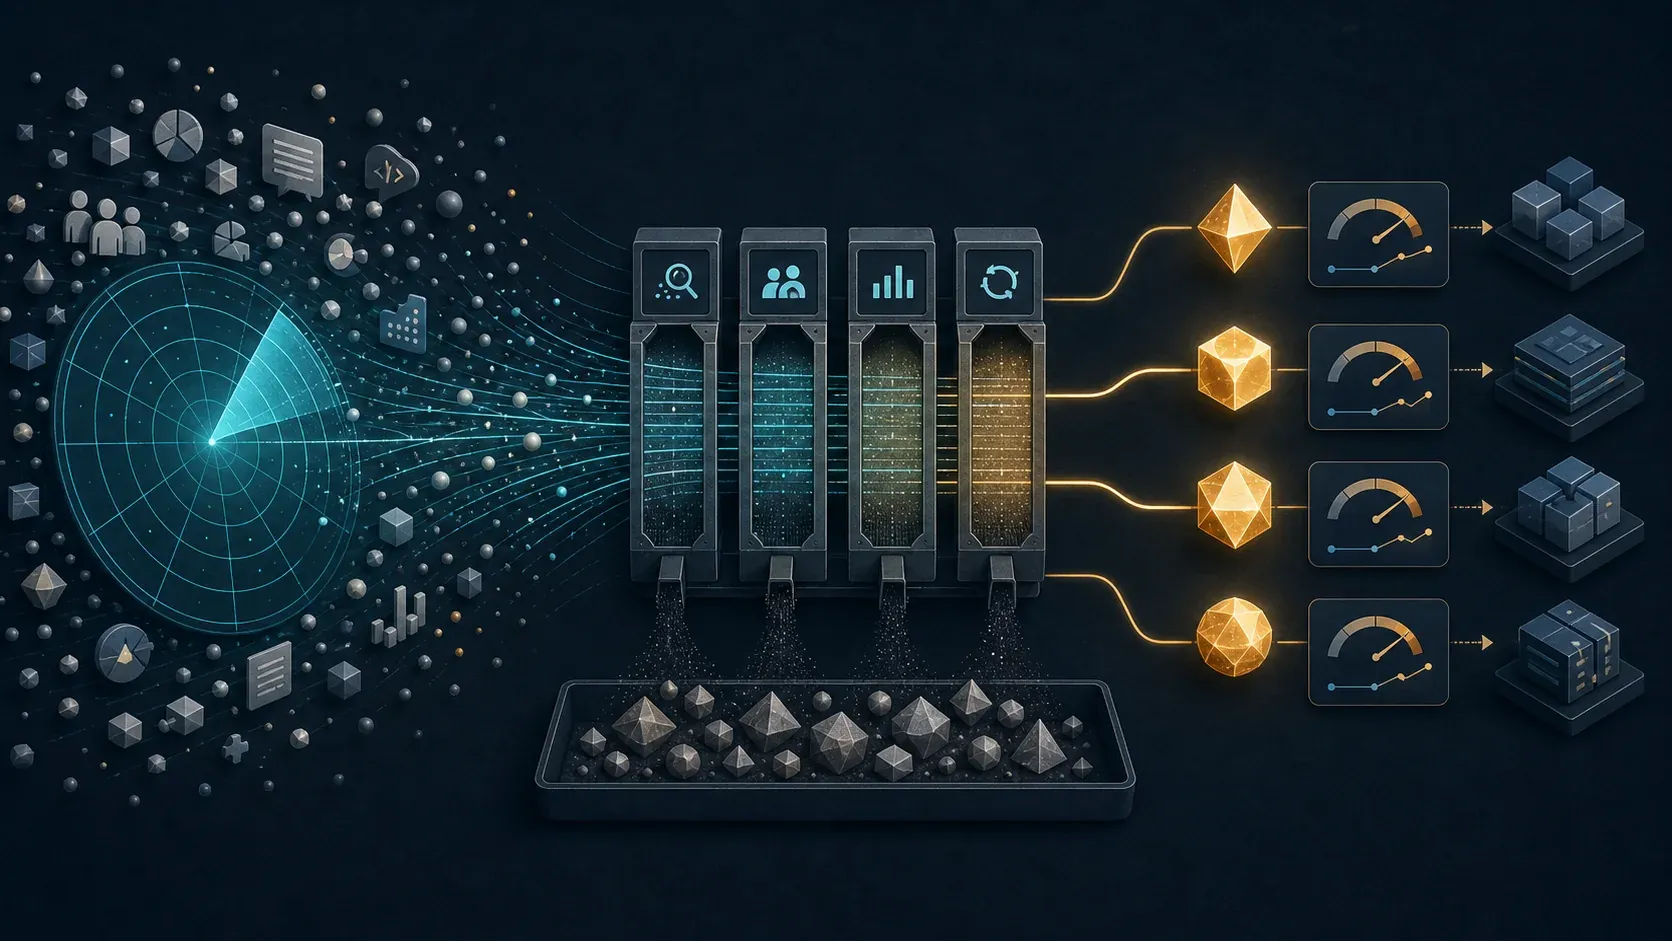
最近我在思考一个比较现实的问题:团队使用 AI 工具之后,开发效率确实提高了,但是需求并没有跟着变多。
之前一个需求可能要做一周,现在三天就做完了。如果团队人数不变,慢慢就会出现一部分人没有足够明确的事情做。这个状态短期看起来很轻松,时间长了比较危险。到了考核的时候,大家会发现自己做了不少零散工作,能说明业务价值、质量提升或者效率变化的东西并不多。
我一开始的想法很直接:做一个 Skill,每天帮团队找一些需求,放进需求池里。这样后面没有事情做的时候,就可以从池子里拿。
后来继续往下拆,发现这个想法有个大问题:如果目标是“每天找几个需求”,AI 太容易完成了,可以快速列出十几个平台、工具、重构、Agent、Skill,看起来每个都有道理,但是大部分只是可以做,不代表值得做。
没有需求很危险,为了填满团队而创造一堆伪需求更危险。
因此我拆成了两个 Skill:一个叫 demand-radar,负责发现信号;另一个叫 valuable-demand-miner,负责判断这个需求值不值得投入。
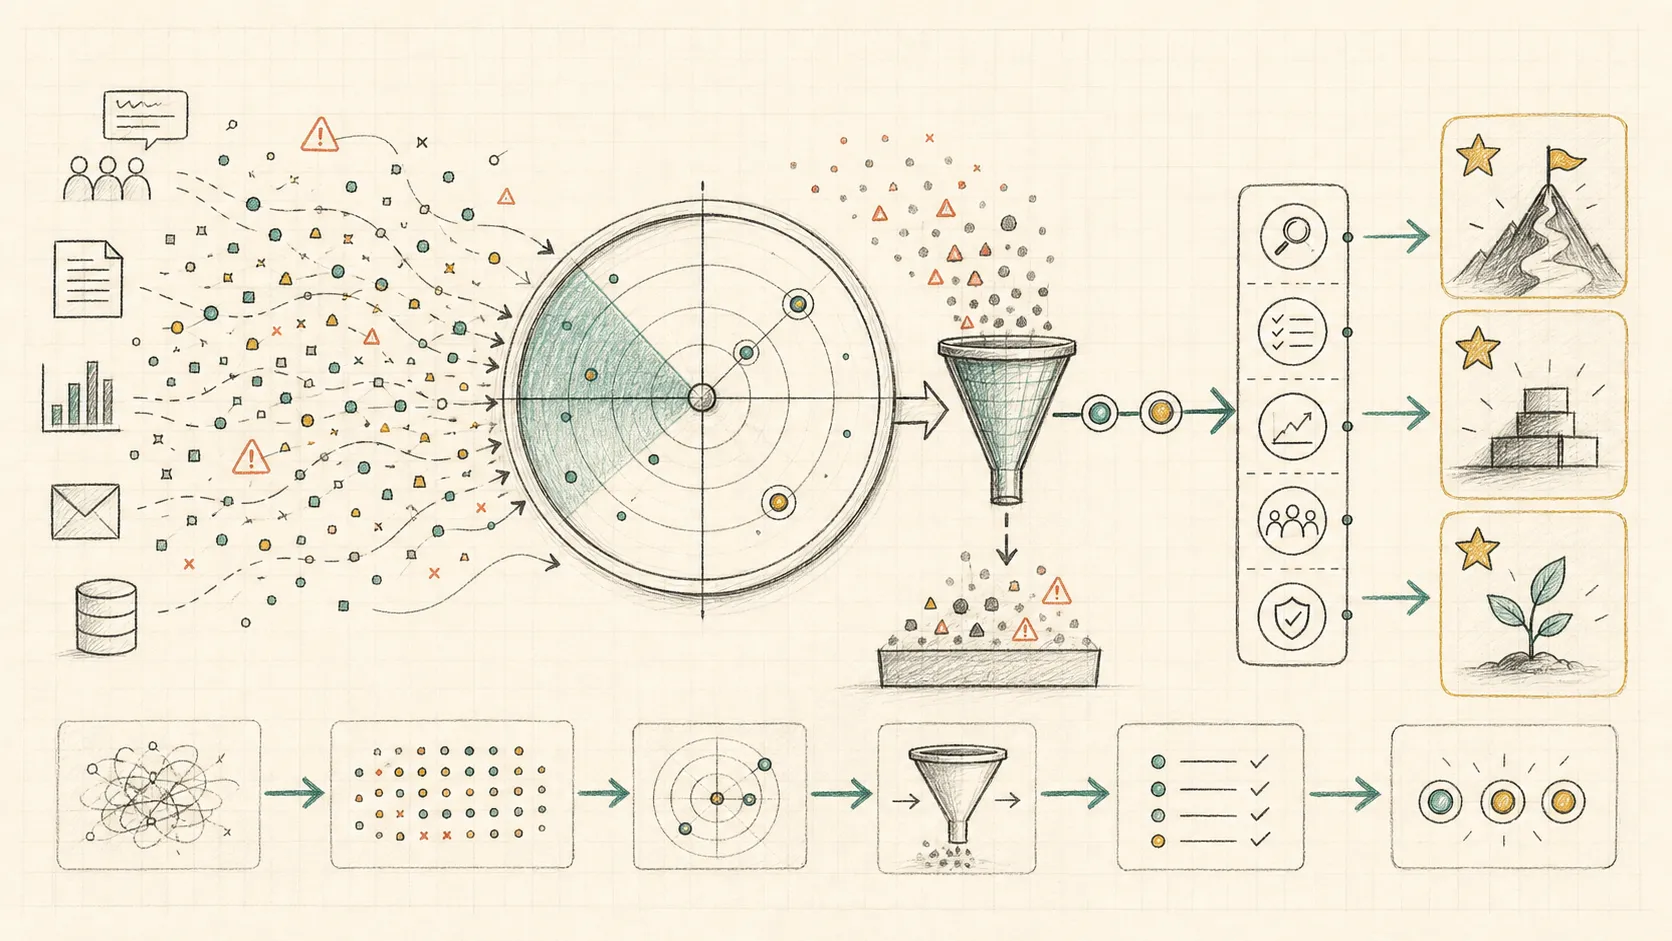
先发现问题,不要急着想方案
需求雷达一开始走了一点弯路。我最早按“业务需求、AI 基建、工程治理”分别设计扫描方式,后来发现搞反了。
需求类型是扫描后才知道的,扫描前不该就把数据分开。一个用户反馈可能变成业务需求,也可能暴露出组件能力缺口;一个反复出现的 Bug,可能是工程治理问题,也可能是现有业务流程设计错了。
因此雷达的流程是:
扫描信号
→ 发现问题或机会
→ 形成候选需求
→ 判断需求类型
→ 定义价值和指标
→ 进入需求池
信号可以来自很多地方:业务会议、用户反馈、项目计划、绩效目标、线上问题、CodeReview、Git 提交、重复的手工工作,甚至是团队人员长期没有明确 Owner 的方向。
但是这些都只是信号。
比如某个目录一个月修改了很多次,只说明它最近很活跃,还要看这些修改是正常的业务迭代,还是反复修同一类 Bug,有没有造成返工、延期或者线上问题,再决定要不要重构。
外面出现一个很强的新模型也一样,要先看团队内部有没有真实问题能用这个能力解决,再决定做不做新平台。
雷达最重要的能力是克制,联想不重要。
挖出来的需求必须能证明价值
继续设计的时候,我发现只记录“需求名称、来源、需求描述”不够。
我们要的是这些需求最终能被立项、验证,并在项目总结和考核时说清楚价值,不是维护一个很长的 backlog。因此一个需求刚挖出来,就要同时定义它准备改变什么。
我把这部分叫做“价值合同”:
为谁解决什么问题
→ 当前情况是什么
→ 希望改善哪个指标
→ 多长时间验证
→ 最后留下什么业务结果或可复用资产
不同需求怎么证明价值不一样。
业务需求要看用户使用、转化、收入、留存,或者是否直接绑定公司的重点业务。AI Coding、AI Engineering 这类基建需求,则要看开发周期、一次测试通过率、返工率、线上缺陷、接入成本和复用次数。
比如“做一个 AI CodeReview Skill”这个描述没有多少价值。更完整的说法应该是:
在两个真实项目中接入 AI CodeReview,记录一次检查通过率、返工次数和线上缺陷,验证它能不能缩短 Review 时间,同时降低 AI 生成代码的质量风险。
如果当前基线不知道,就先写“待测”,下一步先把基线测出来。不要为了让需求看起来完整,随便编一个提升 30%。
方便汇报的需求,要能回答:做了什么、指标发生了什么变化、服务了哪条业务线、后面还能不能复用。
雷达负责发现,矿工负责淘汰
雷达为了不漏掉机会,召回率要高,但是所有候选都直接进入开发,需求池很快就会失控,因此第二步由矿工做更严格的判断。
我给矿工定了几条准入标准:
- 有真实用户、业务方或者明确的内部使用场景;
- 有价值假设和验证指标;
- 有试点、准生产或者上线的路径;
- 做完之后能形成业务结果,或者沉淀成组件、Skill、Eval、模板、SOP 等可复用资产;
- 不存在明显的组织边界、数据安全和业务准确性问题。
过了这些门槛之后,再从战略、业务价值、差异化、复用、质量、落地难度和汇报价值等方面评分。
评分是为了逼自己把缺失的信息暴露出来,数字本身没什么用。一个需求如果不知道谁会使用,不知道怎么验证,也不知道做完后往哪里去,技术上再有意思,也只能先放在观察池里。
最近我用这套方法扫描了一批团队文档和相关代码库。最开始挖出了八个候选,最后五个通过准入,另外三个只保留为待补证据。
被降级的方向很典型:一个是根据代码高频修改推断应该做架构重构,但是还没有 Bug 和返工数据;一个是想做效能看板,但是原始任务数据都不完整;还有一个是把可视化能力接入新的 Agent 平台,但是产品 Owner、真实入口和用户任务都没有确认。
这些方向以后可能还会做,现在没有资格占用正式开发资源。
我感觉矿工最大的价值,是挡住了三个“看起来应该做”的项目,选出五个高分需求倒在其次。
需求池不能变成点子坟场
需求池不能只增不减。原始证据可以留着,候选需求必须有状态变化,比如:
待补证据
→ 待评分
→ 已认领
→ 验证中
→ 已立项 / 已否决 / 已过期 / 已合并
同一个问题出现了新证据,追加到原来的候选上,不要重新生成一个标题。一个候选放了一个月还没有人补证据,也没有业务方认领,就过期或者归档。
不然 AI 每天生成几个点子,一个月之后池子里就有上百条需求,看起来事情很多,没有一个人在推进。
我目前考虑的节奏是:每天只扫描增量信号,每周做一次合并和澄清,每两周把成熟候选交给矿工评分,每月清理一次长期没有进展的项目。
后面的规则
AI 基建必须绑定真实项目,至少被两个成员或两个项目使用,才算有比较强的价值。一次扫描没有发现正式需求也可以,不要为了数量降低标准。
接下来还要用真实项目继续跑,看看哪些门槛太松,哪些指标没有用,再逐步调整。